
توضیحات
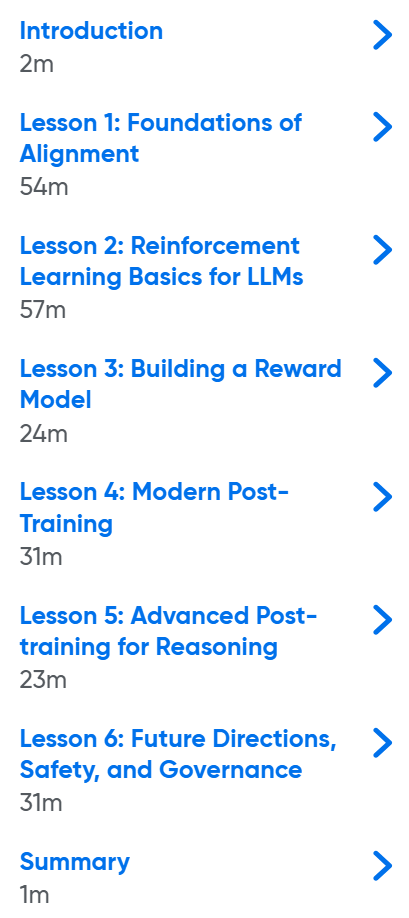
دوره Reinforcement Learning for LLM Alignment and Reasoning. این دوره آموزشی به یادگیری تکنیکهای پس از آموزش، یادگیری تقویتی، همسوسازی مدلهای زبانی بزرگ و ارتقای قابلیتهای استدلال پیچیده آنها میپردازد. مرحله پیشآموزش به مدلهای زبانی بزرگ مهارت و توانایی میبخشد، اما لزوماً قضاوت درست و ایمنی را تضمین نمیکند. در این دوره آموزشی تخصصی، فراگیران یاد میگیرند که چگونه تکنیکهای یادگیری تقویتی مانند بهینهسازی ترجیح مستقیم و بهینهسازی سیاست نسبی گروهی، رفتار، ایمنی و استدلال مدل را شکل دهند و چگونه سیستمهای ارزیابی و حاکمیتی را برای حفظ مسیر همسوسازی پیادهسازی کنند. این برنامه آموزشی به بررسی دقیق مفاهیم پیشرفته پرداخته و نشان میدهد که چگونه میتوان از مدلهای زبانی بزرگ به شیوهای ایمن، قابل اعتماد و کارآمد بهرهبرداری کرد. فرآیند آموزشی این دوره در چندین درس ساختاریافته تنظیم شده است که از مبانی همسوسازی و تعریف چهار شکل اصلی آن یعنی آموزشی، رفتاری، سبکی و ارزشی آغاز میشود. در ادامه، مبانی یادگیری تقویتی برای مدلهای زبانی بزرگ، نحوه ساخت و ارزیابی مدلهای پاداش با استفاده از مقایسههای زوجی و مدل بردلی-تری، و تکنیکهای مدرن پس از آموزش مانند روشهای آفلاین و آنلاین مورد بحث قرار میگیرد. همچنین بخشهای ویژهای به پسصنایع پیشرفته برای استدلال منطقی و مسیرهای آینده، امنیت، ارزیابی مهارها، و اجرای پایپلاین هوش مصنوعی قانونمند اختصاص یافته است تا شرکتکنندگان دیدگاهی همهجانبه و عملیاتی به دست آورند. این دوره برای توسعهدهندگان، دانشمندان داده و مهندسان یادگیری ماشینی طراحی شده است که قصد دارند مدلهای زبانی را بهینهسازی کرده و قابلیتهای ایمنی و استدلال آنها را ارتقا دهند. با گذراندن این مباحث، افراد قادر خواهند بود سامانههای هوش مصنوعی ایمنتر و مجهز به مکانیزمهای نظارتی پیشرفته بسازند و چالشهای دنیای واقعی در توسعه مدلهای هوشمند را به بهترین شکل مدیریت کنند.
آنچه فرا خواهید گرفت
- مفاهیم همسوسازی: تمایز میان همسوسازیهای آموزشی، رفتاری، سبکی و ارزشی و درک ضرورت آنها در مدلهای مدرن.
- مدلهای پاداش: ساخت و ارزیابی مدلهای پاداش با استفاده از مقایسههای زوجی و قوانین بردلی-تری برای سنجش ترجیحات.
- تکنیکهای پس از آموزش: به کارگیری روشهای مدرن مانند بهینهسازی ترجیح مستقیم و بهینهسازی سیاست نسبی گروهی.
- ارزیابی و پایش ایمنی: طراحی ابزارهای ارزیابی برای نظارت بر ایمنی، میزان سمیت خروجیها و انحراف مدلها.
- پایپلاین هوش مصنوعی قانونمند: پیادهسازی ساختارهای خودارزیابی، بازبینی پاسخهای ناایمن و تثبیت رفتارهای اصلاحشده.
- استدلال پیشرفته: تسلط بر روشهای پس از آموزش برای تسریع زنجیرههای منطقی و حل مسائل چندمرحلهای پیچیده.
این دوره مناسب افرادیست که
- مهندسان یادگیری ماشین: متخصصانی که به صورت فعال مشغول تنظیم دقیق و استقرار مدلهای زبانی بزرگ هستند.
- دانشمندان داده: افرادی که میدانند چگونه با دادهها کار کنند و به دنبال بهبود قابلیتهای امنیتی و کارایی مدلها هستند.
- توسعهدهندگان نرمافزار: برنامهنویسانی که تسلط کافی بر زبان پایتون و اصول یادگیری عمیق دارند و میخواهند دانش خود را در حوزه هوش مصنوعی توسعه دهند.
- طراحان سیستمهای هوش مصنوعی: افرادی که به دنبال ایجاد ساختارهای حاکمیتی و ارزیابی برای نظارت بر رفتار مدلها در محیط پروداکشن هستند.
مشخصات دوره
- ناشر: Oreilly
- مدرس: Sinan Ozdemir
- سطح آموزش: متوسط
- مدت زمان آموزش: 12 ساعت و 12 دقیقه
سرفصل های دوره
تصاویر دوره Reinforcement Learning for LLM Alignment and Reasoning
نمونه فیلم دوره
راهنمای نصب
پس از Extract، با Player دلخواه خود مشاهده کنید.
زیرنویس: انگلیسی
کیفیت: 720p
لینک دانلود
گذرواژه فایل(ها): www.downloadly.ir
حجم فایل
4.7 گیگابایت