

توضیحات
دوره LLM & Transformer Mathematics: AI Explained Step by Step. این دوره آموزشی یک راهنمای جامع و بصری برای درک عمیق ریاضیات پشت مدلهای زبانی بزرگ (Large Language Models) و معماری ترانسفورمر (Transformer) است که نحوه عملکرد داخلی آنها را به صورت گامبهگام توضیح میدهد. این دوره به بررسی عمیق ساختار هوش مصنوعی مدرن میپردازد تا فراگیران بتوانند از سطحینگری عبور کرده و ریاضیات پایهای پشت مدلهای LLM و ترانسفورمرها را درک کنند. مفاهیمی مانند Embeddings، Positional Encoding، ماتریسهای Query-Key-Value و مکانیسم Attention در این دوره به عنوان جعبه سیاه در نظر گرفته نمیشوند، بلکه به صورت بصری و ریاضی تجزیه میشوند تا دقیقاً مشخص شود در داخل یک Transformer چه اتفاقی میافتد. آموزش با نحوه نمایش عددی زبان از جمله Tokenization، Vocabularies و Token Encoding آغاز میشود و سپس به سمت Embeddings و فضاهای برداری پیوسته پیش میرود. در ادامه، دوره به یکی از مهمترین مباحث یعنی Positional Encoding میپردازد و نشان میدهد که چرا ترانسفورمرها به اطلاعات موقعیتی نیاز دارند و چگونه از توابع Sine و Cosine برای نمایش موقعیت Tokenها استفاده میشود. سپس مکانیسم Attention به عنوان قلب ترانسفورمر به شکل دقیق بررسی میگردد؛ فراگیران ضربهای داخلی (Dot Products)، نمرههای اولیه توجه (Raw Attention Scores) و تبدیل آنها به وزنهای توجه (Attention Weights) از طریق Softmax را محاسبه میکنند. در نهایت، مفهوم Multi-Head Attention و نحوه درک روابط مختلف در یک دنباله متنی به همراه تکنیکهای Masked Language Modeling و الگوریتمهای BERT و DistilBERT به شکل کامل تشریح میشود تا بدون پیچیدگیهای غیرضروری، درک شهودی و ریاضی قوی برای علاقهمندان و متخصصان هوش مصنوعی ایجاد شود.
آنچه فرا خواهید گرفت
- نحوه تبدیل متن به Tokens، شناسه عددی و Vector Embeddings پیوسته توسط LLMها
- محاسبه Positional Encodings با استفاده از توابع Sine و Cosine و درک نحوه نمایش ترتیب کلمات در Transformers
- تجزیه ریاضی مکانیسم Self-Attention با استفاده از ماتریسهای Query، Key و Value، ضربهای داخلی و Attention Scores
- محاسبه Attention Weights با تابع Softmax و طی کردن مسیر کامل از Input Embeddings تا نمایشهای زمینهای (Contextual Representations)
- درک عملکرد Multi-Head Attention و نحوه استخراج روابط مختلف بین Tokenها توسط سرفصلهای متعدد توجه
- اتصال مفاهیم Tokenization، Embeddings، Positional Encoding و Attention برای درک جامع پردازش متن در مدلهای مبتنی بر Transformer
این دوره مناسب افرادیست که
- توسعهدهندگان و مهندسان نرمافزار (Software Engineers) که مایل به درک عمیقتر ترانسفورمرها، Embeddings و مکانیسمهای Attention هستند
- دانشجویان Data Science و Machine Learning که قصد دارند شهود ریاضی خود را در زمینه مدلهای زبانی مدرن تقویت کنند
- فراگیران AI و Generative AI که میخواهند از اتفاقات درون LLMها آگاه شوند
- متخصصان AI که با LLMها کار میکنند و میخواهند مفاهیمی نظیر QKV، Self-Attention، Softmax و Positional Encoding را با اطمینان توضیح دهند
- افراد حرفهای و علاقهمندان فنی که میخواهند فراتر از توضیحات سطحی در حوزه LLM حرکت کنند
مشخصات دوره LLM & Transformer Mathematics: AI Explained Step by Step
- ناشر: Udemy
- مدرس: Adrian Găitan, Evaluris Solutions, Reju Kole
- سطح آموزش: مبتدی تا پیشرفته
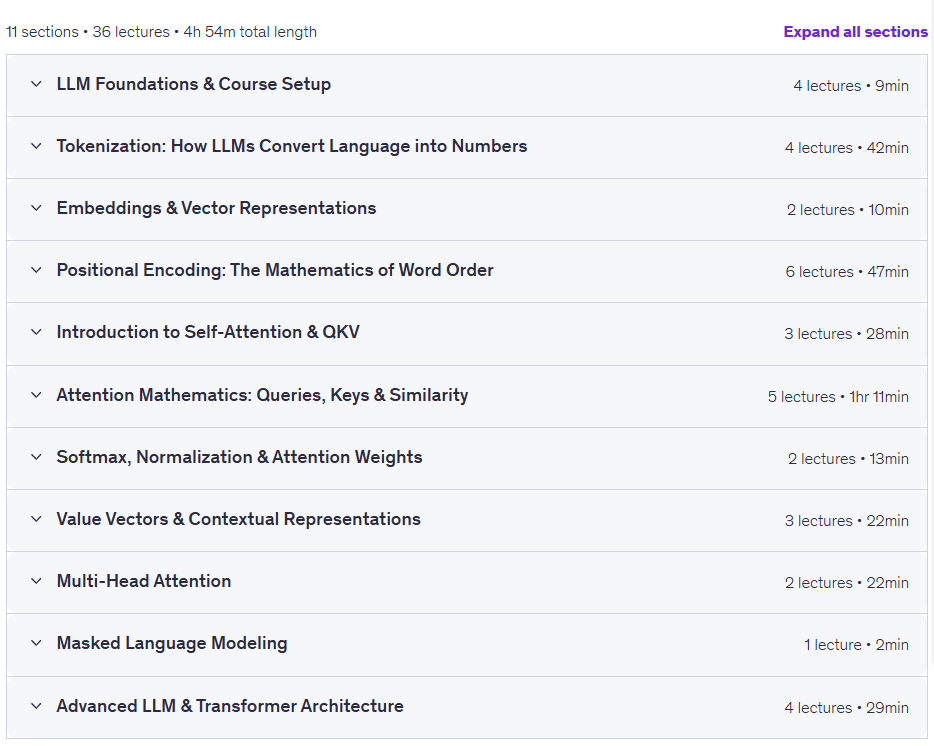
- مدت زمان آموزش: 4 ساعت و 54 دقیقه
- تعداد دروس: 36
سرفصل های دوره
پیشنیازهای دوره LLM & Transformer Mathematics: AI Explained Step by Step
- No prior experience with LLM mathematics or Transformer architecture is required.
- Basic high-school mathematics is helpful, but the mathematical concepts are explained step by step.
- An interest in AI, machine learning or Large Language Models is the only essential prerequisite.
- Basic Python knowledge is helpful for following the optional experiment notebook, but it is not required for the core course.
تصاویر دوره
نمونه فیلم دوره
راهنمای نصب
پس از Extract، با Player دلخواه خود مشاهده کنید.
زیرنویس: ندارد
کیفیت: 1080p
لینک دانلود
گذرواژه فایل(ها): www.downloadly.ir
حجم فایل
2.1 گیگابایت