
توضیحات
دوره Introduction to Vector Databases. این دوره آموزشی جامع به معرفی و آموزش اصول پایهای پایگاههای داده برداری، نحوه کارکرد آنها و ساخت سیستمهای بازیابی اطلاعات مبتنی بر معنا میپردازد. جستجو بر اساس کلمات کلیدی متوقف شده و جستجو بر اساس مفاهیم جایگزین آن میشود. این دوره آموزشی به شرکتکنندگان کمک میکند تا اصول بنیادین پایگاههای داده برداری، اجزای کلیدی آنها و برنامههای کاربردی که با این فناوری قابل ساخت هستند را به صورت کامل بیاموزند. ابزارهای سنتی جستجو که بر اساس تطابق دقیق کلمات کار میکنند، غالباً در درک و ثبت نیت واقعی انسانها با شکست مواجه میشوند و سازمانها را در پیدا کردن اطلاعات مرتبط از میان حجم انبوهی از دادههای ساختارنیافته مانند اسناد متنی و فایلهای پیدیاف دچار مشکل میکنند. در این دوره تخصصی، فراگیران توانایی طراحی و ساخت سیستمهای بازیابی آگاه از زمینه را کسب میکنند که قدرتبخش برنامههای نوین هوش مصنوعی هستند. در ابتدا، مبانی امبدینگها و معیارهای فاصله بررسی میشود تا نحوه نمایش و اندازهگیری معنای مفهومی توسط رایانهها به خوبی درک شود. سپس مکانیسمهای اصلی پایگاههای داده برداری، از جمله ایندکسگذاری تقریبی نزدیکترین همسایه و فیلتر کردن فرادادهها برای بازیابی با کارایی بالا، شناخته میشوند. در نهایت، نحوه پیادهسازی روندهای کاربردی هوش مصنوعی مانند تولید افزوده بازیابی و سیستمهای توصیهگر آموزش داده میشود. پس از پایان این دوره، مهارتها و دانش لازم درباره پایگاههای داده برداری به دست میآید تا از سیستمهای خشک و مبتنی بر کلمات کلیدی به سمت بازیابی هوشمند و فعال هوش مصنوعی حرکت کنید.
آنچه فرا خواهید گرفت
- مبانی امبدینگها: شناخت نحوه تبدیل دادههای متنی و اطلاعاتی به بردارهای عددی برای درک بهتر رایانهها.
- معیارهای فاصله: یادگیری روشهای اندازهگیری شباهت معنایی و فاصله بین بردارهای مختلف.
- مکانیسمهای پایگاه داده برداری: تسلط بر اجزای اصلی و ساختار داخلی پایگاههای داده مدرن.
- ایندکسگذاری تقریبی: استفاده از الگوریتمهای جستجوی سریع برای یافتن سریعترین و نزدیکترین همسایهها در حجم وسیعی از دادهها.
- فیلتر کردن فرادادهها: ترکیب جستجوی برداری با فیلترهای ساختاریافته برای بازیابی دقیقتر اطلاعات.
- تولید افزوده بازیابی: پیادهسازی تکنیک پیشرفته RAG برای اتصال مدلهای زبانی به دادههای اختصاصی.
- سیستمهای توصیهگر: ساخت سامانههای هوشمند پیشنهاد محتوا و کالا بر اساس شباهتهای معنایی.
این دوره مناسب افرادیست که
- توسعهدهندگان نرمافزار: برنامهنویسانی که میخواهند برنامههای کاربردی خود را به قابلیتهای جستجوی معنایی مجهز کنند.
- مهندسان هوش مصنوعی: متخصصانی که به دنبال بهبود دقت مدلهای زبانی بزرگ با استفاده از پایگاههای داده برداری هستند.
- دانشمندان داده: افرادی که با حجم زیادی از دادههای ساختارنیافته سروکار دارند و میخواهند سیستمهای بازیابی اطلاعات کارآمد بسازند.
- علاقهمندان به فناوریهای نوین: افرادی که میدانند چگونه از ابزارهای هوش مصنوعی برای حل مسائل پیچیده جستجو استفاده کنند.
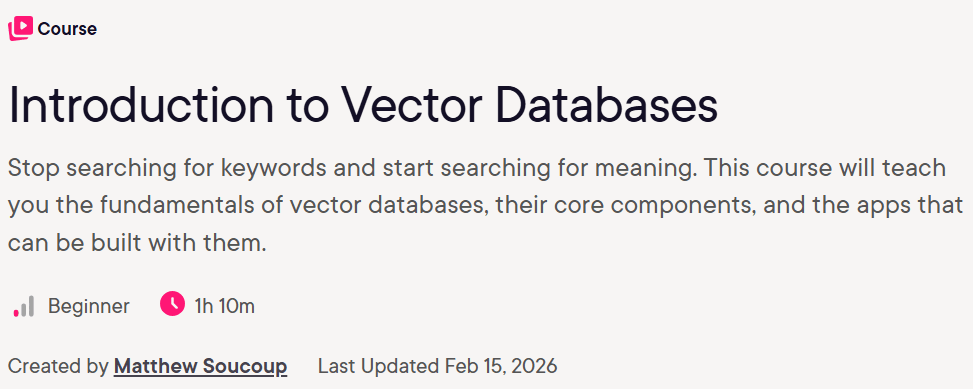
مشخصات دوره Introduction to Vector Databases
- ناشر: Pluralsight
- مدرس: Matthew Soucoup
- سطح آموزش: مبتدی
- مدت زمان آموزش: 1 ساعت و 10 دقیقه
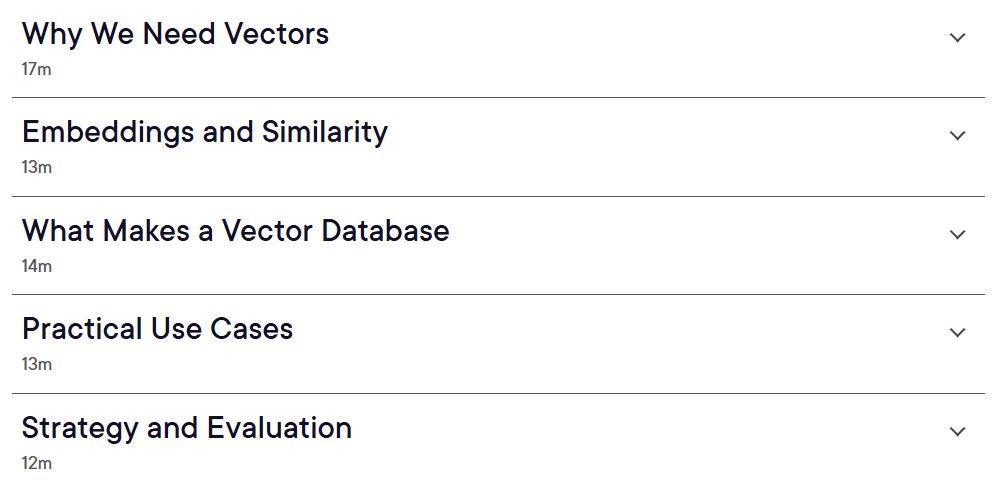
سرفصل های دوره
تصاویر دوره
نمونه فیلم دوره
راهنمای نصب
پس از Extract، با Player دلخواه خود مشاهده کنید.
زیرنویس: انگلیسی
کیفیت: 720p
لینک دانلود
گذرواژه فایل(ها): www.downloadly.ir
حجم فایل
165 مگابایت