
توضیحات
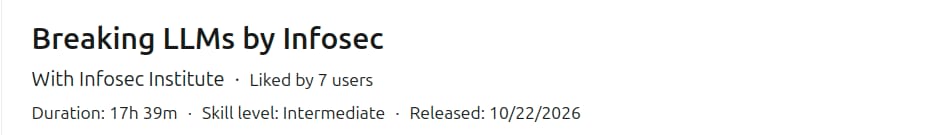
Breaking LLMs by Infosec، دوره آموزش شکستن و به چالش کشیدن مدل های زبانی بزرگ توسط آکادمی LinkedIn Learning منتشر شده است.حمله های خصمانه به مدل های زبانی بزرگ (LLM) می توانند آسیب پذیری هایی را آشکار کنند که روش های سنتی آزمون امنیتی اغلب از شناسایی آن ها باز می مانند. در این دوره، تکنیک های پیشرفته برای آزمایش و به خطر انداختن سامانه های مبتنی بر LLM را بررسی می کنید؛ از جمله حمله های چندوجهی با ورودی های تصویری و صوتی، تزریق پیشرفته دستور، دور زدن سازوکارهای حفاظتی، نادیده گرفتن منطق و محدودیت های مدل و استخراج داده های حساس سامانه. همچنین یاد می گیرید چگونه معماری های تولید تقویت شده با بازیابی (RAG) را از طریق مسموم سازی منابع داده خارجی، مخدوش کردن بردارهای پایگاه داده برداری، سوءاستفاده از تزریق غیرمستقیم دستور، دستکاری منطق بازیابی و رتبه بندی و وادار کردن سامانه به بازیابی زمینه مخرب به خطر بیندازید. این دوره حمله به عامل های خودمختار را نیز بررسی می کند؛ از جمله سوءاستفاده از ضعف های منطق برنامه ریزی، ربودن گردش کار عامل، استفاده نادرست از ابزارها و APIها، ارتقای سطح دسترسی و ایجاد مصرف بیش از حد منابع. افزون بر این، با حمله به پروتکل زمینه مدل (MCP)، روش های وارون سازی و استخراج مدل و آزمون نظام مند برنامه های مبتنی بر LLM با دسترسی محدود به API آشنا می شوید.
آنچه خواهید آموخت
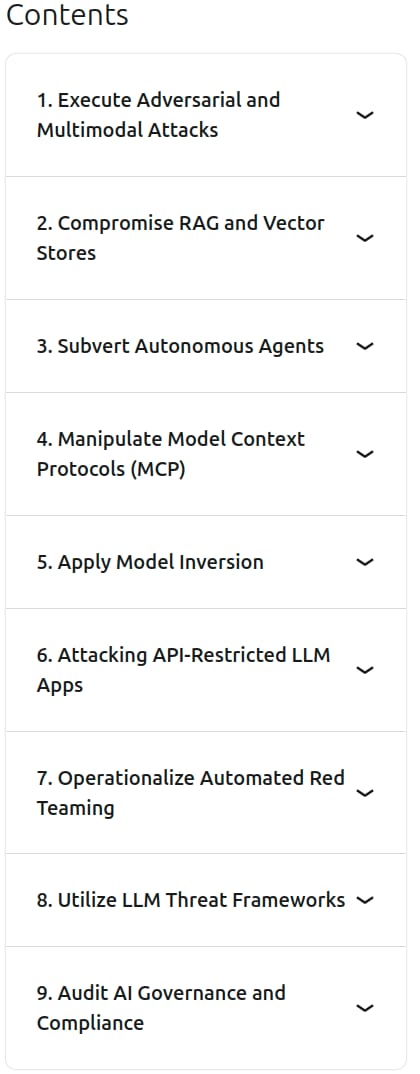
- حمله های خصمانه علیه LLMها را شناسایی و آزمایش کنید؛ از جمله تزریق پیشرفته دستور، محموله های چندوجهی، دور زدن سازوکارهای حفاظتی و نادیده گرفتن محدودیت های منطقی.
- حمله ها علیه سامانه های تولید تقویت شده با بازیابی (RAG) را بررسی کنید؛ از جمله مسموم سازی منابع داده، مخدوش کردن بردارهای تعبیه، تزریق غیرمستقیم دستور و دستکاری فرایند بازیابی.
- سطح حمله عامل های هوش مصنوعی خودمختار را تحلیل کنید و خطرهای مرتبط با منطق برنامه ریزی، ربودن چرخه عامل، استفاده نادرست از ابزارها و APIها، ارتقای سطح دسترسی و مصرف بیش از حد منابع را ارزیابی کنید.
- ضعف های امنیتی پروتکل زمینه مدل (MCP) را بررسی کنید؛ از جمله حمله به منابع و ابزارها، سردرگمی پروتکل، ناهماهنگی وضعیت و سوءاستفاده از درگاه یا لایه انتقال.
- روش های وارون سازی و استخراج مدل را درک کنید؛ از جمله حمله های استنباط عضویت، استنباط ویژگی ها و بردارهای تعبیه، استخراج داده های آموزشی، سرقت مدل و شبیه سازی API.
- روش های حمله به برنامه های مبتنی بر LLM با دسترسی محدود به API را ارزیابی کنید؛ از جمله چارچوب های خودکارسازی مرورگر، احراز هویت پایدار و چالش های آزمون جعبه سیاه.
- آزمون تهاجمی خودکار هوش مصنوعی را با استفاده از ابزارهای اسکن آسیب پذیری، هماهنگ سازی حمله و آزمون فازی مانند Garak، PyRIT، Promptfoo و Deepteam عملیاتی کنید.
- چارچوب های نوین تهدیدهای هوش مصنوعی را به کار بگیرید و حاکمیت و انطباق هوش مصنوعی را بر اساس استانداردهای مرتبط، از جمله قانون هوش مصنوعی اتحادیه اروپا، ISO 42001، راهنمایی های OWASP، ماتریس MITRE ATLAS و چارچوب های NIST ارزیابی کنید.
این دوره برای چه کسانی مناسب است
- متخصصان امنیت هوش مصنوعی که می خواهند آسیب پذیری های سامانه های مبتنی بر LLM را شناسایی، ارزیابی و برطرف کنند.
- هکرهای اخلاقی و آزمونگران نفوذ که قصد دارند مهارت های خود را در آزمون خصمانه LLMها، سامانه های RAG، عامل های خودمختار و پیاده سازی های MCP گسترش دهند.
- مهندسان هوش مصنوعی، متخصصان امنیت برنامه ها و کارشناسان فناوری که مسئول آزمون، ایمن سازی یا حاکمیت سامانه های هوش مصنوعی هستند.
مشخصات دوره Breaking LLMs by Infosec
- ناشر : Linkedin
- مدرس : Infosec Institute
- زبان: انگلیسی
- سطح آموزش: تمام سطوح
- مدت زمان آموزش: 17 ساعت و 39 دقیقه
سر فصل های دوره Breaking LLMs by Infosec
تصاویر
فیلم نمونه
راهنمای نصب
پس از Extract، با Player دلخواه خود مشاهده کنید.
زیرنویس: انگلیسی
کیفیت: 1080p
لینک دانلود
گذرواژه فایل(ها): www.downloadly.ir
حجم فایل
4.46 گیگابایت