
توضیحات
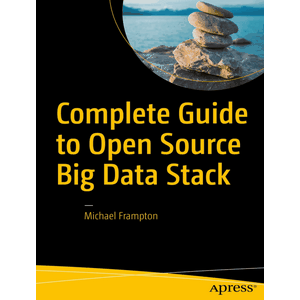
کتاب Complete Guide to Open Source Big Data Stack. امروزه مدیریت و پردازش حجم عظیمی از دادههای بزرگ یا همان کلانداده (Big Data)، بدون بهرهگیری از ابزارهای متنباز امکانپذیر نیست. کتابی که توسط «مایکل فرامپتون» تالیف شده است، به عنوان یک راهنمای کاملاً عملی و گامبهگام، نحوه ساخت، پیکربندی و یکپارچهسازی یک پشته کلانداده (Big Data Stack) مبتنی بر سیستمهای آپاچی را آموزش میدهد. این اثر با اتخاذ رویکردی پروژه-محور، مخاطب را از ابتداییترین مراحل یعنی راهاندازی یک ابر خصوصی بر روی کلاسترهای محلی، تا استقرار پلتفرمهای پیشرفته هدایت میکند تا نحوه تعامل ابزارهای مختلف کلانداده به طور ملموس درک شود.
تمرکز اصلی این راهنما بر روی سیستمهای کامل و در حال توسعه بنیاد نرمافزاری آپاچی است. نویسنده در هر فصل به معرفی یکی از اجزای حیاتی این پشته پرداخته و راههای تهیه نرمافزار، نصب و پیکربندی تخصصی آن را به اشتراک میگذارد. مباحثی چون ذخیرهسازی ابری، مدیریت منابع، پیامرسانی و صفبندی دادهها، پردازش جریانی و تصویرسازی دادهها در قالب پروژههای ساختیافته بررسی میشوند تا متخصصان شبکه و مهندسان داده بتوانند زیرساختهایی پایدار، مقیاسپذیر و ایمن را برای سازمان خود طراحی و پیادهسازی کنند.
ویژگی های کتاب
- آموزش گامبهگام و عملی راهاندازی ابر خصوصی بر روی کلاسترهای محلی با استفاده از Apache CloudStack.
- آموزش جامع نصب، پیکربندی و یکپارچهسازی ابزارهای محوری مانند Brooklyn، Mesos، Kafka و Zeppelin.
- بررسی کاربردی پلتفرم DCOS جهت مدیریت و پردازش توزیعشده کلاندادهها.
- پیادهسازی نمونههای عملی از زیرساختهای ذخیرهسازی ابری، مدیریت توزیع و بصریسازی دادهها.
- تمرکز بر معماری پشتههای متنباز محبوب مانند SMACK (شامل Spark، Mesos، Akka، Cassandra و Kafka).
مشخصات کتاب
- ناشر: Apress
- مدرس / نویسنده: Michael Frampton
- تعداد صفحات: 309
- تعداد فصل ها: 9
- فرمت: PDF
سرفصلها

تصاویر

راهنمای استفاده
فایل را اکسترکت و با نرم افزار مناسب اجرا کنید.
لینک دانلود
گذرواژه فایل(ها): www.downloadly.ir
حجم فایل
5.6 مگابایت