
توضیحات
دوره LLM Serving, Deployment & Scaling – Ollama, vLLM & Ray Serve. این دوره آموزشی یک برنامه جامع و پیشرفته برای یادگیری اصول سرویسدهی، استقرار و مقیاسپذیری مدلهای زبانی بزرگ با استفاده از ابزارهایی مانند Ollama، vLLM و Ray Serve است. این دوره تخصصی از مجموعه Uplatz روی فناوریها، مفاهیم و الگوهای معماری کاربردی تمرکز دارد که برای اجرا، سرویسدهی، استقرار و مقیاسپذیری مدلهای زبانی بزرگ (LLM) به کار گرفته میشوند. مدلهای زبانی بزرگ زمانی کارایی لازم را از خود نشان میدهند که به شکلی مطمئن و بهینه در اختیار برنامهها، کاربران و سیستمهای تجاری قرار گیرند. فراگیران در این دوره آموزشی با مبانی پایهای استنتاج (Inference) و سرویسدهی از جمله توکنایزیشن، تولید توکن، تاخیر (Latency)، توان عملیاتی (Throughput)، دستهبندی درخواستها (Batching)، حافظه پنهان KV (KV Cache)، کوانتایزیشن (Quantisation) و پاسخهای جریانی (Streaming Responses) آشنا میشوند. در ادامه، ابزار Ollama به عنوان یک بستر ساده و در دسترس برای اجرای محلی مدلها معرفی میشود و شرکتکنندگان نحوه نصب، مدیریت مدلها، استفاده از محیط خط فرمان، فراخوانی API و یکپارچهسازی مدلهای محلی با پایتون را میآموزند. همچنین استانداردهای مربوط به APIهای سازگار با OpenAI آموزش داده میشود تا برنامهها بتوانند با استفاده از فرمتهای استاندارد درخواست و پاسخ، با زیرساختهای مختلف ارتباط برقرار کنند. بخش بعدی دوره بر سرویسدهی با عملکرد بالا به وسیله vLLM متمرکز است که شامل مفاهیمی چون PagedAttention، دستهبندی پیوسته (Continuous Batching) و بهینهسازی حافظه GPU میشود. سپس Ray Serve برای استقرار توزیعشده، ارکستراسیون، مسیریابی درخواستها، مقیاسپذیری خودکار (Autoscaling) و مدیریت خطا معرفی میگردد. در نهایت، با استفاده از FastAPI، Docker و Docker Compose اجزای مختلف سیستم بستهبندی شده و دوره با یک پروژه جامع تولیدی به پایان میرسد.
آنچه فرا خواهید گرفت
- درک مفهوم سرویسدهی مدلهای زبانی بزرگ و تفاوت آن با فرآیند آموزش مدل (Training)
- نحوه عملکرد استنتاج مدلهای زبانی بزرگ و تبدیل پرامپتها به توکنها
- مدیریت تاخیر (Latency) و توان عملیاتی (Throughput) برای بهبود عملکرد سیستم
- بهبود کارایی GPU با استفاده از دستهبندی (Batching) و دستهبندی پیوسته (Continuous Batching)
- بهینهسازی مصرف حافظه و سرعت تولید با استفاده از حافظه پنهان KV (KV Cache) و تکنیک کوانتایزیشن (Quantisation)
- اجرای و مدیریت مدلهای زبانی به صورت محلی با استفاده از ابزار Ollama و فراخوانی آن از طریق پایتون
- استفاده از APIهای سازگار با OpenAI و کتابخانه پایتون OpenAI با زیرساختهای مختلف مدل
- افزایش کارایی استنتاج با استفاده از vLLM و مدیریت حافظه با PagedAttention
- استقرار توزیعشده و ارکستراسیون برنامههای هوش مصنوعی با استفاده از Ray Serve
- مدیریت مسیریابی درخواستها، مقیاسپذیری خودکار (Autoscaling) و تحمل خطا (Fault Tolerance)
- ساخت لایه API برنامهنویسی با استفاده از چارچوب وب FastAPI
- بستهبندی برنامهها و مدیریت سرویسها با استفاده از Docker و Docker Compose
- پیادهسازی یک پروژه جامع تولیدی (Production Project) با ترکیب تمامی مباحث دوره
این دوره مناسب افرادیست که
- توسعهدهندگان نرمافزار و مهندسین هوش مصنوعی که میخواهند مدلهای زبانی بزرگ را در محیطهای واقعی مستقر کنند
- مهندسین یادگیری ماشین که به دنبال یادگیری تکنیکهای بهینهسازی استنتاج و مقیاسپذیری سیستمها هستند
- برنامهنویسان پایتون علاقهمند به یادگیری ابزارهای پیشرفته مانند Ollama، vLLM و Ray Serve
- افرادی که میخواهند نحوه ساخت و استقرار سیستمهای هوش مصنوعی مقیاسپذیر را از صفر تا سطح تولیدی بیاموزند
مشخصات دوره LLM Serving Deployment & Scaling – Ollama vLLM & Ray Serve
- ناشر: Udemy
- مدرس: Uplatz Training
- سطح آموزش: مبتدی تا پیشرفته
- مدت زمان آموزش: 6 ساعت و 28 دقیقه
- تعداد دروس: 13
سرفصل های دوره
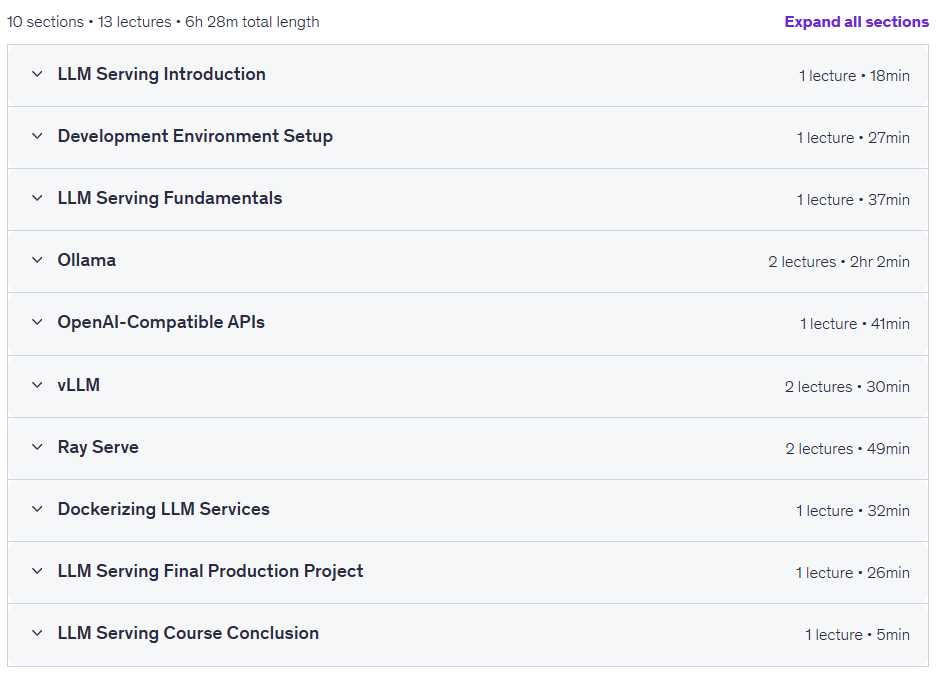
پیشنیازهای دوره LLM Serving Deployment & Scaling – Ollama vLLM & Ray Serve
- Enthusiasm and determination to make your mark on the world!
تصاویر دوره
نمونه فیلم دوره
راهنمای نصب
پس از Extract، با Player دلخواه خود مشاهده کنید.
زیرنویس: ندارد
کیفیت: 1080p
لینک دانلود
گذرواژه فایل(ها): www.downloadly.ir
حجم فایل
2.2 گیگابایت