
توضیحات
دوره LLM Reinforcement Learning Fine-Tuning DeepSeek Method GRPO. این دوره آموزشی یک برنامه تخصصی و پروژهمحور است که روشهای جامع و پیشرفته بهینهسازی و تنظیم دقیق Large Language Models (LLMs) را با تمرکز ویژه بر تکنیک یادگیری تقویتی GRPO معرفیشده در مدلهای DeepSeek آموزش میدهد. در این دوره آموزشی، فراگیران وارد دنیای Large Language Models (LLMs) شده و روشهای بهینهسازی سرتاسری را از مفاهیم پایه تا سطوح پیشرفته میآموزند. مسیر یادگیری با رویکرد SFT (Supervised Fine-Tuning) آغاز میشود؛ جایی که نحوه آمادهسازی اصولی دادهها و ایجاد مجموعه دادههای سفارشی با استفاده از tokenizers و data collators از طریق مثالهای عملی بررسی میگردد. در طول فرآیند SFT، تکنیکهای کلیدی برای سبکتر و کارآمدتر کردن مدلهای بزرگ به کمک LoRA (Low-Rank Adaptation) و quantization آموزش داده شده و نحوه یکپارچهسازی گامبهگام آنها در پروژهها تشریح میشود. پس از تثبیت مبانی SFT، مباحث به سمت DPO (Direct Preference Optimization) حرکت میکند. روش DPO این امکان را فراهم میسازد که با بازتاب مستقیم بازخورد کاربران در مدل، نتایجی کاربرمحور به دست آید. فراگیران نحوه قالببندی دادهها برای این روش، طراحی مکانیزم پاداشدهی (reward mechanism) و نحوه اشتراکگذاری مدلهای آموزشدیده در پلتفرمهای محبوبی مانند Hugging Face را فرا میگیرند. علاوه بر این، درک عمیقتری از نحوه عملکرد data collators در فرآیندهای DPO و تکنیکهای عملی آمادهسازی و تبدیل مجموعه دادهها در سناریوهای مختلف به دست میآورند. مهمترین بخش این دوره به GRPO (Group Relative Policy Optimization) اختصاص دارد که به دلیل تولید نتایج قدرتمند، محبوبیت فراوانی یافته است. با استفاده از GRPO، روشهایی برای بهینهسازی رفتار مدل نه تنها در سطح فردی، بلکه در میان جوامع یا گروههای کاربری مختلف آموزش داده میشود. این رویکرد باعث میشود مدلهای زبانی بزرگ به شکلی نظاممندتر و موثرتر به مخاطبان یا اهداف متنوع خدمترسانی کنند. در این بخش، اصول بنیادین GRPO تدریس شده و سپس دانش فراگیران با اعمال این تکنیک بر روی مجموعه دادههای واقعی تثبیت میشود. در سراسر این آموزش، مباحث کلیدی شامل LoRA، quantization، SFT، DPO و به ویژه GRPO در کنار یکدیگر پوشش داده شده و هر مبحث با کاربردهای پروژهمحور پشتیبانی میشود. با پایان یافتن این دوره، شرکتکنندگان توانایی مدیریت کامل تمامی مراحل از آمادهسازی سرتاسری دادهها تا تنظیم دقیق و بهینهسازی مبتنی بر سیاستهای گروهی را کسب کرده و توسعه راهحلهای مدرن و رقابتی LLM مبتنی بر عملکرد بالا و رضایت کاربر برای آنها بسیار سادهتر خواهد شد.
آنچه فرا خواهید گرفت
- درک اصول بنیادین Large Language Models (LLMs) و ساختار کلی حاکم بر فرآیندهای آموزش آنها
- شناخت تفاوتهای میان base models و instruct models و همچنین روشهای آمادهسازی داده برای هر یک از آنها
- یادگیری تکنیکهای پیشپردازش داده همراه با نکات ضروری، نحوه شناسایی special tokens مورد نیاز مدلها و درک قالبهای داده
- کسب تجربه عملی و دانش دقیق درباره نحوه عملکرد LoRA و Data Collator در فرآیند آموزش
- به دست آوردن درک عمیق از hyperparameters حیاتی مورد استفاده در آموزش، شامل هدف و نحوه عملکرد آنها
- یادگیری عملی و دقیق نحوه ادغام ماتریسهای آموزشدیده LoRA با base model و نکات کلیدی و بهترین شیوههای این فرآیند
- شناخت ماهیت Direct Preference Optimization (DPO)، نحوه عملکرد آن، قالب داده مورد انتظار و سناریوهای خاص کاربرد آن
- یادگیری ملاحظات کلیدی هنگام آمادهسازی داده برای DPO و درک نحوه عملکرد DPO data collator
- آشنایی با hyperparameters خاص مورد استفاده در آموزش DPO، نقشها و نحوه عملکرد آنها
- یادگیری نحوه بارگذاری مدل آموزشدیده در پلتفرمهایی مانند Hugging Face و مدیریت موثر hyperparameters پس از آموزش
- درک دقیق نحوه عملکرد روش یادگیری تقویتی Group Relative Policy Optimization (GRPO) و مکانیزم یادگیری آن
- یادگیری نحوه آمادهسازی دادهها به صورت اختصاصی برای Group Relative Policy Optimization (GRPO)
- آموزش ساخت reward functions به عنوان حیاتیترین بخش GRPO از طریق مثالهای عملی و متنوع
- آشنایی کامل با قالب مناسب دادهها برای ارائه به توابع پاداش GRPO و نحوه پردازش این دادهها درون توابع
- یادگیری نحوه تعریف پاداشها درون توابع و ایجاد الگوهای شفاف پاداشدهی (reward templates) برای GRPO
- کسب مهارت عملی در استخراج بخشهای شایسته پاداش از پاسخهای خام و تعریف پاداش بر اساس این بخشهای استخراجشده
- یادگیری نحوه تبدیل یک مدل Instruct به مدلی با توانایی تولید استدلال زنجیره افکار (Chain of Thought) از طریق GRPO
این دوره مناسب افرادیست که
- دانشمندان داده (Data scientists) و مهندسان یادگیری ماشین (ML engineers) که میخواهند در تکنیکهای آموزش Large Language Model (LLM) تخصص پیدا کنند
- افرادی که قصد دارند بر نکات ضروری و بهترین شیوههای آمادهسازی داده تسلط یابند
- توسعهدهندگان هوش مصنوعی (AI developers) که هدف ساخت مدلهای زبانی سفارشی خود را دنبال میکنند
- علاقهمندانی که به دنبال تجربه عملی با تکنیکهای پیشرفتهای مانند Supervised Fine-Tuning (SFT)، Direct Preference Optimization (DPO) و Group Relative Policy Optimization (GRPO) هستند
- افرادی که میخواهند تجربه عملی و کاربردی با تکنیک Group Relative Policy Optimization (GRPO) کسب کنند
- کسانی که تمایل دارند نکات کلیدی آمادهسازی داده را بیاموزند و مجموعه دادههای سفارشی خود را برای مدلهای زبانی سازگار نمایند
- افراد علاقهمند به روشهای یادگیری تقویتی (reinforcement learning) و بهینهسازی مدلها بر اساس بازخورد کاربران
مشخصات دوره LLM Reinforcement Learning Fine-Tuning DeepSeek Method GRPO
- ناشر: Udemy
- مدرس: Çağatay Demirbaş
- سطح آموزش: مبتدی تا پیشرفته
- مدت زمان آموزش: 3 ساعت و 45 دقیقه
- تعداد دروس: 43
سرفصل های دوره
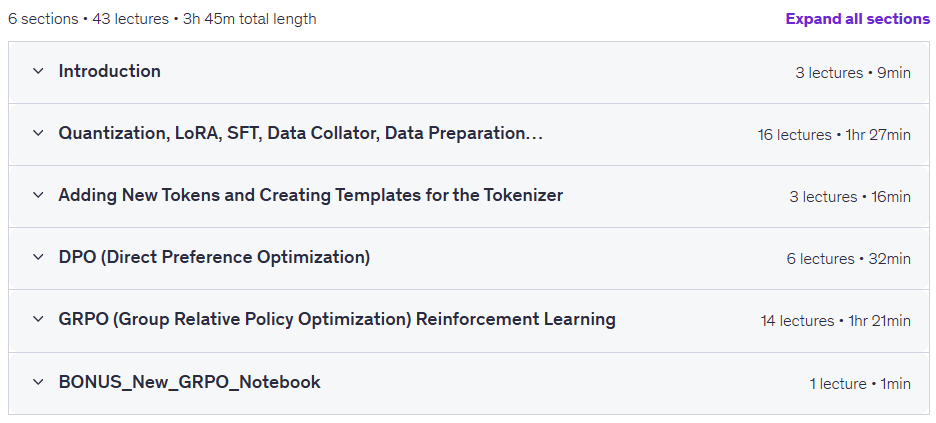
پیشنیازهای دوره LLM Reinforcement Learning Fine-Tuning DeepSeek Method GRPO
- Basic knowledge of Python programming.
- Introductory-level familiarity with artificial intelligence and machine learning concepts.
- Ideally, prior experience with Jupyter Notebook or Google Colab.
تصاویر دوره
نمونه فیلم دوره
راهنمای نصب
پس از Extract، با Player دلخواه خود مشاهده کنید.
زیرنویس: انگلیسی
کیفیت: 1080p
لینک دانلود
گذرواژه فایل(ها): www.downloadly.ir
حجم فایل
1.8 گیگابایت